改动背景:
1、之前是处理服务触发时间的前一天的数据,但是这个会使得早上出现的店铺异常,下午依旧无法截获,只能等到第二天才能截获,降低了当天成功率。
2、服务执行过程中,某个类型如果失败,或者系统部因为资源问题临时暂停了服务,无法得知上一次执行成功的时间。
本初优化:
1、服务触发时间改为30分钟一次(通知系统部处理)
2、服务获取错误刊登数据的时间周期长度为:1小时,每次只处理1小时内更新的异常数据,如果从上次成功执行结束时间到当前时间不足1小时,终止执行(筛选的时间字段UpdateTime,“1小时”这个需要可以方便修改)
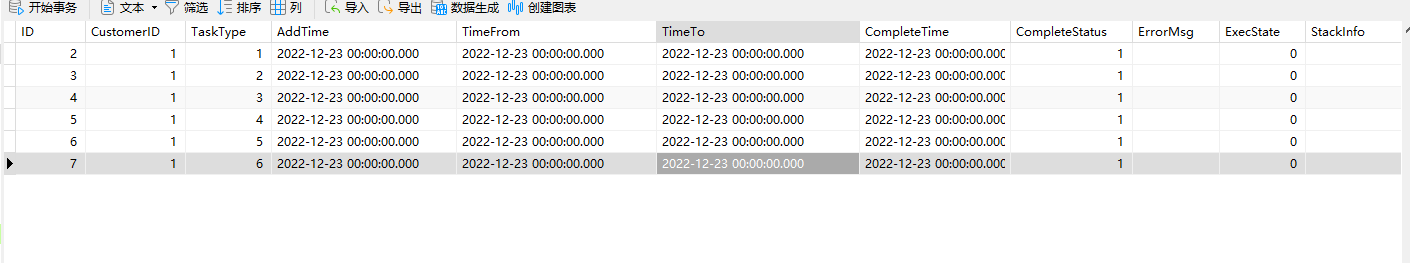
3、建立“刊登异常任务执行队列表”(RB_Amazon_ErrorTask_Queue),记录每个类型的数据、每次的执行情况。如果没有执行成功,从最后一次失败的时间节点开始执行,避免服务被停止后漏跑数据(规避改动背景第2点)
4、队列表必有字段(其他字段根据上下文需求处理):商户号、异常任务类型、队列创建时间、执行开始时间、执行结束时间(未正常结束null)、执行状态(0未处理、1成功,2失败)、报错描述(1000字符,超出手动截断)